3줄 요약
- 직접 써보니 AI 성능은 Claude Code, 도구 완성도는 Codex가 앞섰고 둘 다 월 $20부터 시작함
- 공개 Terminal-Bench 4.0에선 둘 다 57.9%로 동점인데, 시도 한 번에 Codex(GPT-6 Astra)는 $7.12, Claude Code(Fable 5.1)는 $14.76을 썼음
- Antigravity, Cursor, Muse Code는 값이 같거나 싸지만 셋 다 걸리는 데가 하나씩 있음
넷은 $20, Meta만 $5
| 도구 | 첫 유료 요금제 | 상위 요금제 | 요금제에 든 모델 |
|---|---|---|---|
| Claude Code | Claude Pro $20 | Max $100부터 | Opus 5.5, Sonnet 5.5, Fable 5.1은 추가 크레딧 차감 가능 |
| Codex | ChatGPT Plus $20 | Pro $100부터 | GPT-6 Astra, Sol, Luna |
| Antigravity | 무료, 또는 Google AI Pro $19.99 | Ultra $99.99 / $199.99 | Gemini 3.1 Pro·3.8 Flash, Claude 4.6, gpt-oss-120b |
| Cursor | Pro $20 | Pro+ $60, Ultra $200 | Grok 4.7·Composer 2.5 전용 한도, 다른 회사 모델은 API 가격 |
| Muse Code | Everyday $5 | High $15, Power $50 | Muse Spark 1.3 |
미국 월 요금, 세금 제외, 2026년 9월 29일 확인: Anthropic, OpenAI, Google, Cursor, Meta
- OpenAI 추정치로 Plus에서 GPT-6 Astra는 5시간에 로컬 메시지 5
45개, 가벼운 Luna는 3503,000개임 - Astra 범위만 해도 위아래가 9배 차이라 실제 한도는 사용량 대시보드를 봐야 앎
- Muse Code $5 요금제는 5시간에 프롬프트 10~50개, $50 요금제는 그 20배임
- Cursor 요금 문서는 에이전트를 매일 쓰는 사람의 월 총사용액을 $60~$100로 잡음
- $20는 입장료고 청구서는 따로 옴
Claude Code와 Codex는 57.9% 동점, 비용은 두 배 차이
- Terminal-Bench 4.0은 코딩 에이전트에 어려운 터미널 과제 66개를 주고 과제마다 5번씩 돌림 (tbench.ai)
- 점수는 도구와 모델을 한 쌍으로 잰 결과임
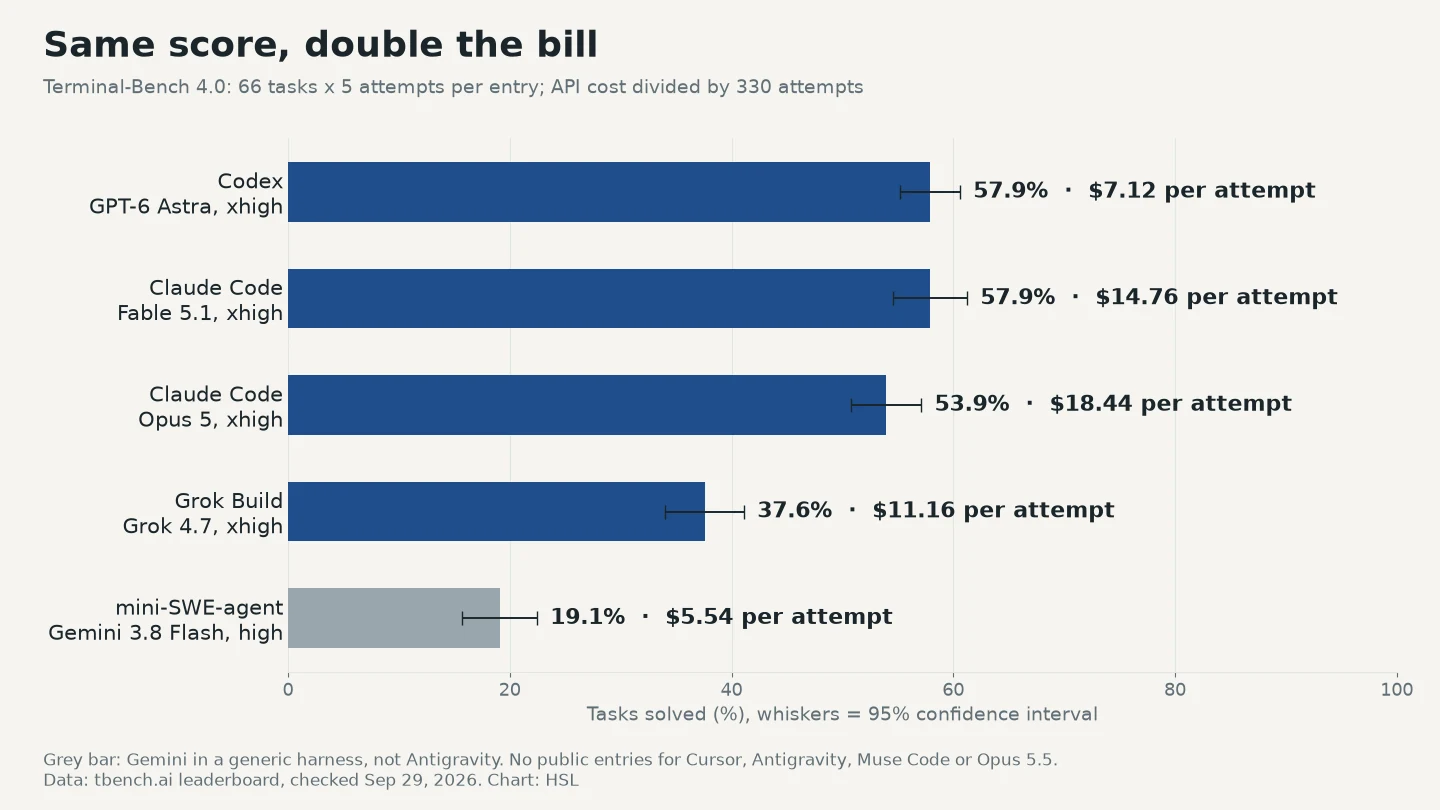
데이터: Terminal-Bench 4.0 리더보드, 항목당 330회 시도, 2026년 9월 29일 확인. 비용은 총 API 비용을 시도 횟수로 나눈 값 — 차트 HSL
- xhigh 설정에서 두 조합 모두 330번 중 191번 풀었음
- 시도 한 번에 Codex는 $7.12, Claude Code는 $14.76을 써서 같은 점수에 두 배를 냄
- max 설정에선 Codex가 58.2%로 살짝 앞서지만 오차 범위 안임
- Anthropic은 신형 Opus 5.5가 자체 측정에서 66.4%라고 발표했는데 공개 리더보드엔 아직 없음 (Anthropic)
- 같은 페이지에서 벤치마크 격차로는 실제 차이를 판단하기 점점 어렵다고 써놓고 바로 밑에 그 표를 붙여놨음
- 내가 써본 바로는 코드 자체는 여전히 Claude Code가 낫고, 그걸 감싼 도구는 Codex가 더 잘 다듬어져 있음
- Opus 5.5로 옮긴 이유는 Astra vs Opus 글에 같은 프롬프트 테스트와 함께 정리해둠
- Codex Plus는 웹, CLI, IDE 확장, iOS에 SSH 원격 접속과 모바일 원격 조작까지 지원함 (OpenAI)
- Claude Code도 Pro부터 클라우드 세션과 Remote Control로 원격 작업이 됨 (Anthropic)
Antigravity는 공짜인데 Claude는 아직 4.6
- 개인용 Antigravity는 무료 요금제까지 전부 Gemini 3.1 Pro, Gemini 3.8 Flash, Claude Sonnet·Opus 4.6, gpt-oss-120b를 줌 (Google)
- $19.99짜리 Google AI Pro로 올려도 늘어나는 건 한도고 모델 목록은 그대로임
- Claude Code는 이미 Opus 5.5라 여기서 공짜로 쓰는 Claude는 몇 세대 전 버전임
- 직접 써보니 빠르고 가성비는 좋은데 전체 완성도가 떨어졌음
- 2.0 앱은 다국어를 지원하지 않고 원격 서버에 붙어서 프로젝트를 여는 기능도 없었음
- 8월 20일 추가된 Remote Control은 반대로 내 컴퓨터 세션을 브라우저에서 조작하는 기능임 (Google)
- 2.0 변경 기록에도 Windows용 WSL 연결은 있지만 다른 서버로 붙는 SSH 연결은 없음 (변경 기록)
- Codex는 이걸 $20짜리 Plus 요금제에서 SSH 원격 접속으로 이미 지원함
- Gemini 3.8 Flash는 범용 하네스로 Terminal-Bench 4.0에서 19.1%였는데, 이건 모델 점수지 Antigravity 점수가 아님
Cursor는 이제 Grok부터 팖
- SpaceX가 8월 14일 Cursor 인수를 마무리했음 (SEC 8-K)
- Cursor Pro 사용량은 Grok 4.7·4.6·4.5와 Composer 2.5용 한도, 다른 회사 모델용 한도로 나뉨 (Cursor)
- Grok 쪽은 "훨씬 넉넉한 기본 사용량"을 받고 Claude와 GPT는 다른 쪽 한도에서 API 가격대로 빠짐
- 한도를 제일 많이 주는 모델과 에디터의 주인이 이제 같은 회사임
- Grok 4.7은 SpaceXAI의 Grok Build로 Terminal-Bench 4.0에서 37.6%라 Codex·Claude Code보다 약 20점 낮음
- Cursor 자체 기록은 리더보드에 없어서 이 차이는 에디터가 아니라 모델 몫임
- Pro에 Cloud Agents가 들어 있어 원격 작업은 됨
- Cursor는 안 써봐서 이 부분은 공개 자료만으로 정리했음
Muse Code는 $5인데 채점은 구버전 시험으로 함
- Muse Code는 Meta의 터미널 코딩 에이전트고 9월 2일부터 Muse Spark 1.3으로 돌아감 (Meta)
- Meta 성적표의 비교 상대는 GPT-6 Astra·Opus 5.5 한 세대 전인 GPT-5.6 Sol과 Opus 5임
- 코딩 항목은 Terminal-Bench 2.1을 썼고 여기서 88.8%가 나옴
- 위의 58%대 점수는 4.0 버전이라 이 숫자와 나란히 놓으면 안 됨
- Astra나 Opus 5.5랑 붙으면 어떤지는 이 표로는 알 수 없음
- Meta 엔지니어들 비교로는 Muse Spark 1.3이 1.2보다 토큰을 약 25% 덜 씀
- Muse Code도 안 써봐서 궁금하면 $5 요금제로 직접 확인하는 게 제일 쌈
그래서 $20은 어디에 냄?
| 원하는 것 | 먼저 써볼 것 | 이유 |
|---|---|---|
| 제일 좋은 코드 | Claude Code, Pro $20 | 결과물은 내 선택, Opus 5.5는 Anthropic 자체 표에서 1위 |
| 완성도 높은 도구, 싼 작업당 비용 | Codex, Plus $20 | 같은 57.9%를 시도당 절반 비용으로 냄, 웹·CLI·IDE·iOS·SSH 지원 |
| 공짜에 빠른 것 | Antigravity 무료 | Gemini 3.1 Pro와 Claude 4.6이 $0, 써보니 다국어와 원격 서버 프로젝트는 안 됨 |
| Cursor 에디터 계속 쓰기 | Cursor Pro + 지출 상한 | Grok 한도는 넉넉, Claude·GPT는 API 가격 |
| 제일 싼 체험 | Muse Code $5 | 독립적인 Terminal-Bench 4.0 결과는 아직 없음 |
- 내 저장소의 실제 작업 하나를 두 도구에 똑같이 시키고 데모 말고 diff를 비교하는 게 제일 확실함
- Codex, Claude Code, Cursor 모두 요금제 한도를 넘으면 추가 사용량을 팔아서 긴 작업 전엔 상한부터 걸어둬야 함
커뮤니티 반응
- Opus 5.5를 써 본 개발자는 일상 코딩엔 Claude를 택했지만, 한 비동기 런타임 설계에선 Astra xhigh가 놓친 구조 문제를 더 찾았다고 했음 (Reddit)
- r/claude에선 Opus 5.5가 더 간결하고 효율적이라는 후기와 뜻밖의 실수가 나온다는 후기가 함께 올라왔음 (Reddit)
- 한 Cursor 사용자는 Grok 4.7을 써 봐도 구현은 Composer 2.5로 돌아오고 계획엔 더 강한 모델을 쓴다고 했음 (Reddit)
Q&A 또 궁금한 것은?
- Q. Claude Code가 Codex보다 나음?
- 공개 리더보드에선 57.9% 동점이고, 코드는 Claude Code가 마음에 들지만 시도당 비용은 Codex가 절반이었음
- Q. Antigravity로 Opus 5.5를 싸게 쓸 수 있음?
- Antigravity 목록엔 Claude Opus 4.6까지만 있어서 안 됨
- Q. Cursor에서 Claude나 GPT는 이제 못 씀?
- 다른 회사 모델용 한도에서 각 모델 API 가격으로 쓸 수 있음
- Q. Muse Code 88.8%면 Codex 58.2%보다 좋은 거 아님?
- Terminal-Bench 2.1과 4.0은 서로 다른 시험이라 비교가 안 됨
- Q. Antigravity로 원격 서버 프로젝트를 열 수 있음?
- 써본 2.0 앱에선 안 됐고, Remote Control은 내 컴퓨터를 브라우저로 조작하는 기능뿐임