
3줄 요약
- Sonnet 5.5는 토큰 단가가 Opus 5.5의 절반이지만 Artificial Analysis가 지금까지 재본 것 중 토큰을 가장 많이 써서, Max에서는 작업당 7.60달러로 Opus 5.98달러보다 비쌈
- 점수를 맞춰 보면 Opus가 이길 수 있는데, Opus 5.5 Xhigh는 Sonnet Max와 같은 56점을 3.46달러에 내고 Artificial Analysis는 Sonnet의 High(47점, 1.08달러)를 가장 경쟁력 있는 설정으로 봄
- 그래도 나는 Sonnet을 High로 시작하고 내 작업에서 통과 작업 하나당 비용을 재볼 것임
Sonnet 5와 같은 2달러·10달러, Opus 5.5의 절반
- Anthropic은 9월 28일 Claude Sonnet 5.5를 내놓았고 Claude 5.5 패밀리의 두 번째 모델이라고 소개함 (Anthropic)
- Haiku 5.5는 아직 "앞으로 몇 주 안에" 나온다고만 되어 있음
- 토큰 단가는 그대로라서 절약이 있다면 작업당 토큰이 줄어서 생긴 것임
| 100만 토큰당 가격 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 입력 | $2 | $4 |
| 출력 | $10 | $20 |
| 캐시 읽기 | $0.20 | $0.20 |
| 캐시 쓰기 | $2.50 | $5 |
출처: Anthropic, Cost and speed 표, 2026년 9월 29일 확인
- Anthropic은 자체 테스트에서 작업당 비용이 Sonnet 5보다 최대 30% 적다고 함
- Artificial Analysis는 Max 기준 작업당 7.60달러가 Sonnet 5보다 약 50% 높다고 함 (Artificial Analysis)
- 두 쪽은 측정 조건이 달라서 같은 조건으로 맞춘 비교는 못 찾았음
- Anthropic 페이지에 인용된 고객 결과는 Box의 전체 토큰 12% 감소부터 Balyasny의 답변당 12.1만 토큰 대 49.7만 토큰(비공개 금융 작업 세트)까지 폭이 큼
- 배치 처리는 50%, 캐싱은 최대 90% 절약이고 미국 내 전용 추론은 1.1배 가격임 (Anthropic)
- 컨텍스트 1M 토큰, 최대 출력 128K는 출시 전 유출본이 Sonnet 5에서 그대로 옮겨 적었던 숫자와 같음 (모델 개요, 출시 전에 쓴 글)
토큰 단가는 절반인데 토큰은 60% 더 씀
- Artificial Analysis 지능 지수에서 Max의 Sonnet 5.5는 56점, Max의 Opus 5.5는 58점임
- Sonnet 5.5는 지수 작업 하나당 출력 토큰을 약 19.3만 개 썼고, 지금까지 잰 것 중 가장 많으며 Max의 Opus 5.5보다 약 60%, Max의 GPT-6 Astra보다 약 7배 많음
- 토큰 단가가 절반인 모델이 작업당 7.60달러로 Opus의 5.98달러보다 비싸진 이유가 이것임
- 단가 할인은 늘어난 토큰값에 대부분 상쇄됨
| effort | Sonnet 5.5 점수 / 작업당 비용 | Opus 5.5 점수 / 작업당 비용 |
|---|---|---|
| Low | 36 / $0.41 | 42 / $0.55 |
| Medium | 41 / $0.59 | 51 / $1.34 |
| High | 47 / $1.08 | 54 / $1.82 |
| Xhigh | 52 / $2.74 | 56 / $3.46 |
| Max | 56 / $7.60 | 58 / $5.98 |
출처: Artificial Analysis 지능 지수 v4.3.2, 기본 폴백 켜짐, Sonnet 5.5·Opus 5.5 릴리스 페이지, 2026년 9월 29일 확인. 비용은 지수 평가 10개 전체의 가중 평균이며 코딩만의 값이 아님
- 같은 effort 이름끼리 비교하면 Max만 빼고 전부 Sonnet이 쌈
- 점수를 맞춰 보면 Opus Medium(51점, 1.34달러)이 Sonnet Xhigh(52점, 2.74달러)와 비슷하고, Opus Xhigh는 Sonnet Max와 같은 56점인데 3.46달러 대 7.60달러임
- 이 두 비교는 공개된 숫자로 내가 계산한 것이고, Opus 비용은 각각 Sonnet의 약 49%, 46%임
- Artificial Analysis는 Sonnet 5.5가 점수 대비 비용 최적선 밖에 있고, High가 가장 경쟁력 있는 설정이며 같은 작업당 비용에서 GPT-6 Sol에 근소하게 뒤진다고 함
- 다만 구조화 출력 버그가 있었다고 Anthropic이 밝힌 출시 전 빌드로 잰 것이고, 평가를 다시 돌릴 예정이라고 함
문서에서 확인되는 건 retry가 아니라 토큰임
- 내 불만은 점수가 무한 retry로 끌어올려진 것 같다는 것이고, Artificial Analysis 벤치에서 Sonnet의 작업당 비용이 토큰 단가는 절반인데도 Opus보다 높게 나오기 때문임
- 무한 retry를 적은 자료는 못 찾았고, Anthropic은 Max effort 5회 시행 평균이고 Artificial Analysis 코딩 에이전트 벤치는 작업당 3회 시도의 pass@1 평균임
- 자료에 실제로 남아 있는 건 토큰 사용량이고, retry 없이도 같은 청구서가 나옴
- Anthropic의 대표 표는 작업당 비용이 가장 큰 Max effort 기준임
| 벤치마크 (Sonnet 5.5는 Max) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% (Xhigh) |
| FrontierCode 1.1 Main | 46.2% | 42.4% | 54.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1, Elo | 1844 | 1449 | 1846 |
출처: Anthropic, 시스템 카드. CursorBench는 Cursor, GDPval-AA는 Artificial Analysis, FrontierCode는 Cognition이 실행했고 Sonnet 5·Opus 5.5 설정은 Anthropic 표기 그대로임
- Artificial Analysis가 직접 돌린 Terminal-Bench 4.0에서는 Max의 Sonnet 5.5가 64%, Opus 5.5가 60%이고 같은 모델에 Anthropic이 낸 70.6%보다 낮음
- Anthropic의 Terminal-Bench 4.0에서 Opus 5.5를 4.2점 앞선 결과는 표준오차가 Sonnet 약 ±2.5점, Opus 약 ±2.6점이라 단정하기 어려움
- Sonnet 5의 10.3%는 Anthropic이 제시한 숫자이고, 시스템 카드 Terminal-Bench 항목에는 Sonnet 5가 아예 없음
- Artificial Analysis 코딩 에이전트 지수의 Sonnet 5.5 수치는 못 읽어서 위 비용표는 코딩만이 아니라 지수 전체 기준임
Max가 Xhigh한테 졌고, High는 Max보다 7.7점 낮음
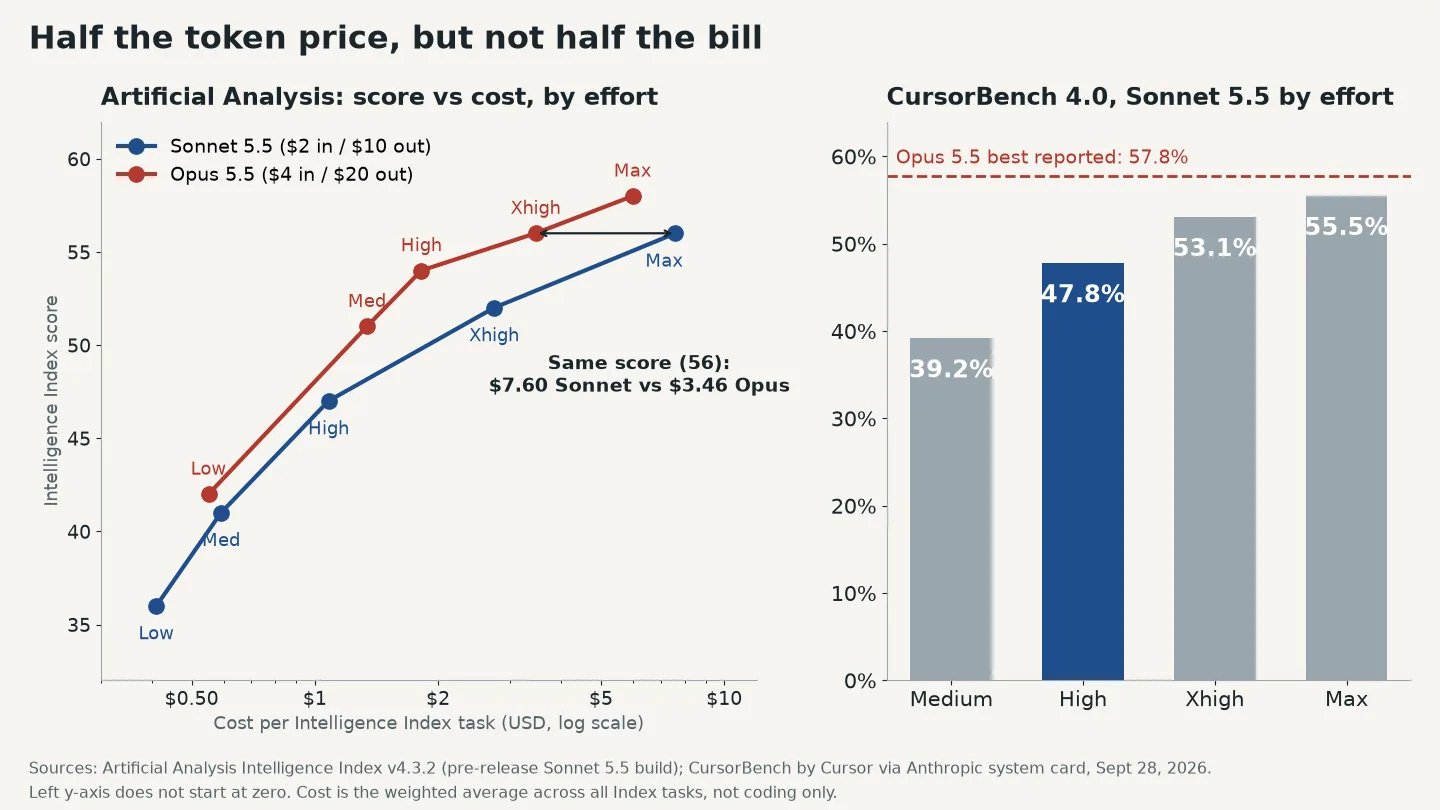
출처: Artificial Analysis 릴리스 페이지, Anthropic 시스템 카드 8.8절(CursorBench는 Cursor 실행). 차트는 HSL 제작
- FrontierCode에서 Sonnet 5.5는 Xhigh 52.1%, Max 46.2%로 Max가 더 낮음
- Anthropic 각주에 따르면 Max에서 Claude Code의 코드 리뷰 스킬이 더 자주 돌아 리뷰가 여러 서브에이전트로 쪼개졌고, Cognition이 살펴본 두 건에서 타임아웃이나 작업 범위 밖 수정이 나왔음
- 리뷰어를 너무 많이 불러서 한 단계 아래 설정에 진 것임
- CursorBench 4.0은 Medium 39.2%, High 47.8%, Xhigh 53.1%, Max 55.5%여서 High는 Max보다 7.7점 낮음
- 그래도 Sonnet 5의 최고 기록 34.1%는 크게 넘음
High를 쓰는 이유는 벤치가 아니라 체감임
- 추론을 High 정도로 잡으니 가성비가 좋았음
- 써보니 개인적으로 만족스러움
- 어디까지나 써본 인상이고 측정한 결과는 아님
- Artificial Analysis 숫자도 이와 어긋나지 않는데 High를 Sonnet의 가장 경쟁력 있는 설정으로 꼽았기 때문임
- 다만 Opus Medium은 지수 작업당 0.26달러만 더 내면 4점 높음(51점 대 47점)
- Anthropic 문서도 API에서는 High를 기본값으로 두고, 명세가 분명한 에이전트 코딩은 Medium을 권하며 Claude Code와 Claude 앱의 기본값도 Medium임 (마이그레이션 가이드)
- Anthropic은 Sonnet 5.5를 범위가 분명한 일상 작업, 버그 수정, 문서 작성용으로, Opus 5.5를 판단이 필요한 복잡한 작업용으로 구분함
갈아탈 때 걸리는 설정들
- 마이그레이션 가이드는 Sonnet 5.5에서 400 오류가 나는 설정 다섯 가지를 적어 둠: thinking 예산, 샘플링 파라미터, 어시스턴트 프리필, 도구 강제 선택,
thinking: {"type": "disabled"} - 사전 thinking을 끄려면
between_tools를 쓰는데 Low·Medium·High에서만 되고 Xhigh·Max에서는 400 오류가 남 - 위험도가 높은 사이버보안 작업은 눈에 보이게 Sonnet 5로 넘어가고, Anthropic의 Terminal-Bench 실행에서는 요청의 1.2%가 대체 모델 답변이었음
- 보존된 thinking이 만든 계정에 묶여서 Claude Code에서 세션 중간에 계정을 바꾸면 영향이 있음
- effort 단계가 다시 보정돼서 같은 단계라도 Sonnet 5와 같은 양을 생각한다는 보장은 없음
내 작업으로 직접 재보기
| effort | 내가 시작할 곳 | 근거 |
|---|---|---|
| Medium | 명세가 분명한 에이전트 코딩, 지연에 민감한 채팅 | Claude Code·앱 기본값 |
| High | 어렵거나 긴 작업, 일반 API 사용 | Claude API 기본값, Artificial Analysis가 꼽은 Sonnet의 최적 설정 |
| Xhigh, Max | 추가 통과분이 토큰값을 할 때만 | Max는 지수 작업당 7.60달러였고 FrontierCode에서 Xhigh에 짐 |
- 정답을 이미 아는 실제 작업 20개를 고름
- Sonnet은 Medium과 High로, 비교용으로 Opus는 Medium으로 돌림
- 통과한 결과 수와 실행마다 쓴 출력 토큰을 기록함
- 모델별 토큰 단가로 계산한 비용을 통과 작업 수로 나눔
- 그 값이 가장 낮은 모델과 설정을 고르고, 리더보드가 Max라고 해도 따라가지 않음
커뮤니티 반응
- r/ClaudeCode에선 Max의 작업당 비용이 Opus보다 높다는 지적과 Medium·High도 보고 판단해야 한다는 반론이 함께 나옴 (Reddit)
- r/ClaudeAI의 한 사용자는 개인 코딩 작업 10개를 High에서 각 3회 돌려 두 모델 모두 Claude Code에서 30/30을 통과했고 시도당 API 비용은 Sonnet 약 $0.15, Opus 약 $0.36이었다고 보고했지만 시험이 이미 포화됐다고 밝힘 (Reddit)
- r/ClaudeAI의 다른 글쓴이는 직접 테스트하지 않았다고 밝히면서 과한 코드 리뷰 서브에이전트 때문에 FrontierCode에서 Max가 Xhigh에 졌다는 Anthropic 각주를 짚음 (Reddit)
Q&A 또 궁금한 것은?
- Q. Sonnet 5.5가 Opus 5.5보다 작업당 쌈?
- 같은 effort 이름끼리는 대체로 싸지만 Artificial Analysis는 Max에서 7.60달러 대 5.98달러로 재었고 Opus Xhigh가 3.46달러로 Sonnet Max와 같은 점수를 냄
- 차이는 Max에서 Sonnet이 출력 토큰을 약 60% 더 쓴 데서 옴
- Q. 벤치마크 점수가 retry로 부풀려진 거 맞음?
- 그렇다고 적은 자료는 못 찾았고, Anthropic은 5회 시행 평균, Artificial Analysis 코딩 에이전트 벤치는 3회 시도의 pass@1 평균임
- Cursor와 Cognition의 실행 방식까지는 못 봤으니 Anthropic과 Artificial Analysis가 공개한 범위만 확인한 것임
- Q. Sonnet 5.5가 Opus 5.5를 대체함?
- Anthropic은 복잡하고 열린 작업은 Opus 5.5가 분명히 더 강하다고 함
- Max 기준으로 GDPval-AA는 1844점 대 1846점으로 거의 같지만 FrontierCode는 46.2% 대 54.4%로 뒤짐
- Q. Claude Code에서는 어떤 effort가 좋음?
- Anthropic 안내는 명세가 분명하면 Medium, 어렵거나 긴 작업은 High이고 기본값은 Medium임
- Q. 쓰던 Sonnet 5 코드가 그대로 돌아감?
thinking: {"type": "disabled"}나 기본값이 아닌 샘플링 값을 보내면 둘 다 400 오류가 나서 안 됨