3줄 요약
- 지능은 여전히 Opus 5.5 쪽이 더 뛰어나다고 느끼지만, 매일 일할 모델로는 내가 선호하는 Codex 안의 GPT-6.1 Sol이 기대됨
- Sol과 Sonnet 5.5는 100만 토큰당 입력 $2·출력 $10으로 같고 Opus의 절반이라, 세 모델을 비교하면 가격만으로 Sol의 승리를 정할 수는 없음
- Codex 작업은 Sol부터 써보고, 범위가 분명한 Claude Code 작업은 Sonnet을 남겨두고, 판단력이 수정 횟수를 줄여주는 일에는 Opus 비용을 내겠음
Opus는 여전히 믿음이 가고 Sol은 다시 궁금해짐
- 전에 쓴 Astra와 Opus 비교에서도 완성된 결과물과 가성비는 Opus 5.5가 더 마음에 들었음
- 지금도 지능적인 부분은 Opus가 더 뛰어나다는 인상임
- GPT-6 Sol은 성능에서 아쉬움이 컸어서 싸다는 이유만으로 다시 쓰고 싶지는 않았음
- 6.1이 궁금한 건 내가 좋아하는 작업 환경 안에서 일상 작업을 맡길 만한 성능이 나올 것 같아서임
- OpenAI는 DeepSWE 1.1에서 이전 Sol의 최고 점수보다 6.4%p 높으면서 effort와 비용은 낮았다고 발표했고, 다시 시험해 볼 이유는 됨 (OpenAI)
- 제조사 측정 결과이며, 이 글은 세 모델을 같은 조건으로 새로 돌린 실험이 아니라 현재 내 선택 기준을 정리한 글임
- 파일 이름 하나 바꾸는 데 최고 지능까지 바라지는 않는데, 어느 파일인지는 알아들었으면 함
Sol과 Sonnet은 기본 단가가 같음
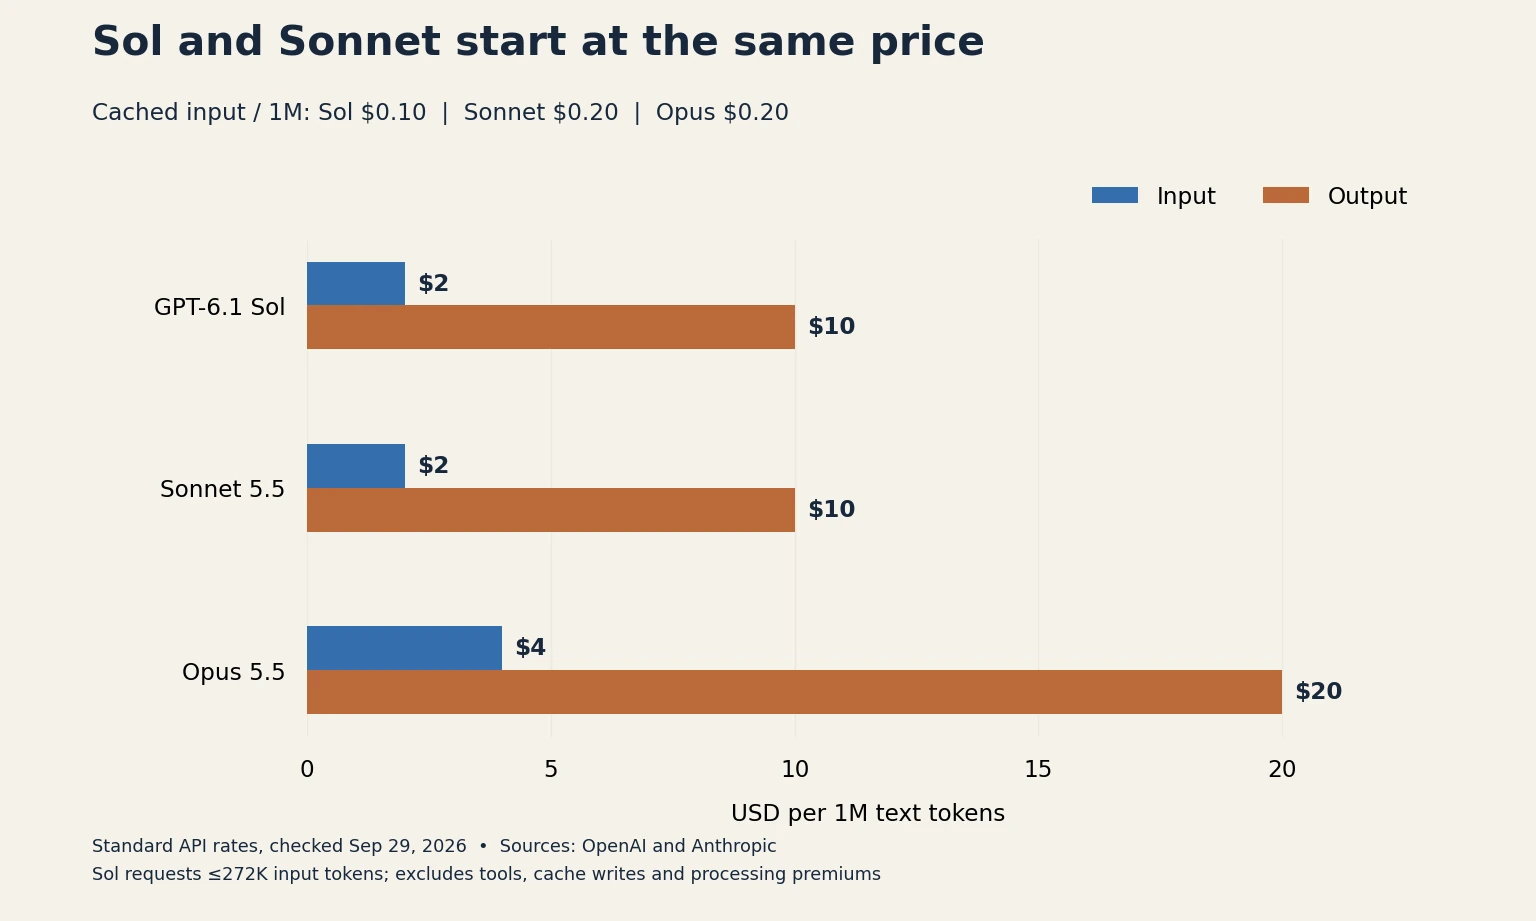
| 모델 | 입력 | 캐시 입력 / 캐시 읽기 | 출력 |
|---|---|---|---|
| GPT-6.1 Sol | $2 | $0.10 | $10 |
| Claude Sonnet 5.5 | $2 | $0.20 | $10 |
| Claude Opus 5.5 | $4 | $0.20 | $20 |
출처: OpenAI 모델 문서, Sonnet 발표, Opus 모델 문서; 텍스트 100만 토큰당 USD, 일반 API 처리 기준, 2026년 9월 29일 확인
- 표의 Sol 요금은 입력 272K 토큰 이하 요청 기준이며, 넘으면 요청 전체에 입력·캐시 2배와 출력 1.5배 요금이 적용됨
- 도구 사용료·캐시 쓰기·처리 옵션 할증은 제외했고 구독 사용량도 별도로 봐야 함
- 캐시 없는 입력 10만 토큰과 출력 2만 토큰을 쓴다고 가정하면 Sol·Sonnet은 $0.40, Opus는 $0.80임
- 토큰 수를 고정한 계산 예시이며 실제 작업에서 측정한 비용은 아님
- $0.40짜리 시도를 똑같이 두 번 하면 이미 $0.80이고, 내가 검수하는 시간은 아직 더하지도 않았음
- 같은 수정에 두 번 돈을 내면 반값 혜택을 꽤 빨리 반납하게 됨
- Sol의 캐시 읽기는 싸지만 적용 가능한 반복 입력 부분의 차이여서 전체 비용이 Sonnet의 절반이 되는 건 아님
Sonnet까지 넣으면 선택이 까다로워짐
- Sonnet 5.5를 쓴 글에서는 High로 일상 작업을 할 때 만족스러웠고, 어려운 일에서 가성비가 떨어졌다고 적었음
- Claude에서 하는 일을 전부 Opus 가격으로 계산하면 이 선택지를 놓치게 됨
- Anthropic도 범위가 분명한 일은 Sonnet, 복잡하고 답이 열려 있는 일은 Opus로 구분하며 Claude Code의 Sonnet 기본값은 Medium임 (공식 설명)
- effort를 올리는 게 무조건 해결책도 아닌데, Anthropic의 FrontierCode 1.1 Main 결과는 Sonnet Xhigh 52.1%, Max 46.2%였음
- 각주에는 살펴본 두 사례에서 코드 리뷰 서브에이전트가 늘면서 시간 초과나 범위 밖 수정에 영향을 줬다고 적혀 있음
- 작은 수정 하나 부탁했다가 리뷰 회의만 커질 수도 있음
- 이 결과는 GPT-6.1 Sol을 측정한 게 아니고, 발표 표의 이전 GPT-6 Sol 점수를 6.1 점수처럼 가져오면 안 됨
- 적절한 설정에서 원하는 결과가 얼마나 나오는지 봐야 작업 하나당 싼 모델을 고를 수 있음
매일 쓸 모델로 Sol이 끌리는 이유는 Codex임
- 작업 환경까지 보면 지금은 Codex가 Claude Code보다 더 강력하고 편하다고 느낌
- 새 기능이 붙는 속도도 좋고, 글·코드·이미지 작업을 오갈 때 흐름을 다시 짜지 않아도 되는 점이 마음에 듦
- 내장 이미지 생성이 그 예이고,
gpt-image-2를 Codex 사용량 안에서 이용하는 구조임 (이미지 생성 문서) - Claude Code도 MCP·스킬·명령 실행·클라우드 작업을 지원해서 기능 유무만 세는 것으로 내 선호를 설명하기는 어려움 (Claude Code 안내)
- 이런 환경까지 묶으면 Sol의 가성비가 상당히 매력적으로 보이지만, Sonnet보다 실제로 얼마나 절약되는지는 같은 작업으로 재봐야 함
| 맡길 일 | 내가 먼저 고를 쪽 | 선택을 바꿀 조건 |
|---|---|---|
| Codex에서 코드·글·이미지를 오가는 일상 작업 | GPT-6.1 Sol | 수정을 반복해서 낮은 단가의 이점이 사라짐 |
| 기존 Claude Code 환경의 범위가 분명한 작업 | Sonnet 5.5 Medium 또는 High | 중간중간 어려운 판단이 계속 필요함 |
| 복잡한 계획이나 답이 열려 있는 어려운 작업 | Opus 5.5 | 더 싼 모델도 같은 수준의 결과를 냄 |
- 직접 비교할 때는 작업·쓸 수 있는 도구·통과 기준을 맞추고 각 모델의 effort를 기록하겠음
- 모든 시도의 API 비용을 합격 작업 수로 나누고, 검수에 쓴 분은 따로 적으면 됨
- 토큰 가격이 같아도 어느 환경에서 일하기 편한지에 따라 내 선택은 달라질 수 있음
커뮤니티 반응
- r/codex의 한 댓글은 그래프 점에 effort 표시가 없다며 High가 Sol의 적정 설정인지 판단하기 전에 각 점의 조건부터 묻고 있음 (Reddit)
- r/ClaudeCode에서는 Sonnet Max의 비용을 비판하는 의견과 Medium·High를 따로 비교해야 한다는 의견이 함께 나옴 (Reddit)
Q&A 또 궁금한 것은?
- Q. Opus가 더 똑똑하면 Codex를 고르는 게 손해 아님?
- 모델 지능에 대한 내 인상과 작업 환경에 대한 선호는 서로 다른 질문이고, 맡길 일에 따라 중요한 쪽이 달라짐
- Q. Sol이 Sonnet의 반값임?
- 표에서 반값인 건 캐시 읽기뿐이며 기본 입력·출력 단가는 같고 실제 사용량은 달라질 수 있음
- Q. Sonnet은 전부 Max로 올리면 됨?
- Medium·High로 이미 통과하는지부터 보고, effort를 더 올리기 전에 Opus와 비교하겠음
- Q. 여기서 세 모델을 같은 작업으로 직접 시험한 것임?
- 아님, 내 선호와 기존 경험에 공식 요금·제조사 평가를 붙인 글이고 제안한 비교 실험은 앞으로 할 일임