3줄 요약
- OpenAI·Anthropic 다음 자리는 Artificial Analysis 지수 기준 Meta Muse Spark 1.3(48점)이고, Grok 4.7과 Xiaomi MiMo-V2.6-Pro가 46점으로 뒤따름
- 중국 AI가 싸다는 말은 Xiaomi와 DeepSeek(과제당 $0.13, $0.27)에만 맞고, Qwen3.8 Max·GLM-5.3·Kimi K3는 과제당 비용이 Opus 5.5(high)보다 비쌈
- 이 비교에 나온 중국 5곳 모두 Anthropic 9월 보고서에서 Claude 무단 증류 혐의를 받았으니, 가격보다 내 프롬프트가 어디로 가는지부터 확인해야 함
2군 1등이 OpenAI 중간 모델과 동점
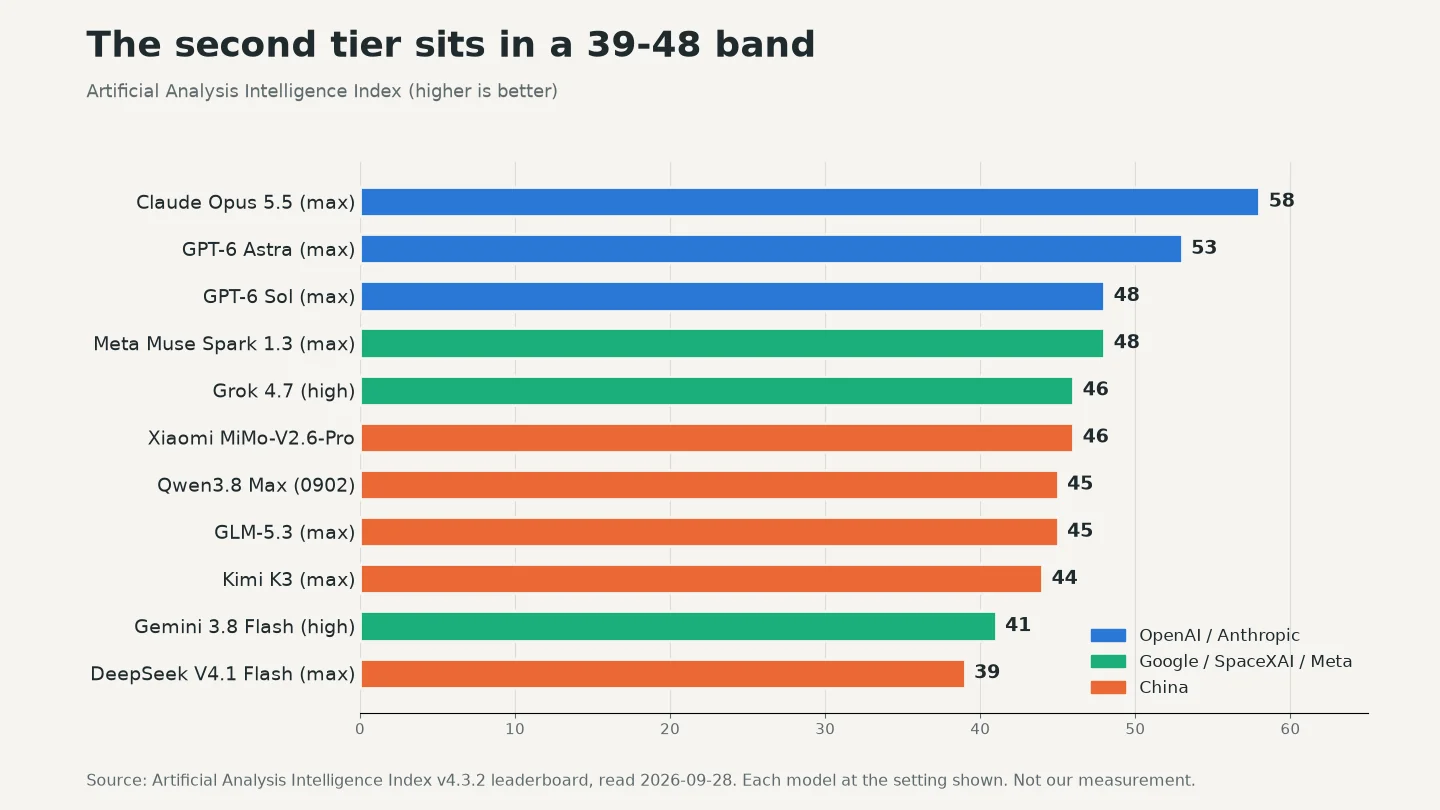
출처: Artificial Analysis — Intelligence Index v4.3.2 순위표, 2026년 9월 28일 확인 — 차트 HSL
- Artificial Analysis는 모든 모델을 직접 돌려서 GDPval, Terminal-Bench 4.0, Humanity's Last Exam 등 평가 10개를 지수 하나로 묶음 (방법론)
- 1위는 Opus 5.5(max) 58점, 2위는 GPT-6 Astra 53점
- 이 차트에선 나머지 8개 회사 모델 8개가 39~48점 사이에 몰려 있음
- 그중 1등은 Meta Muse Spark 1.3으로 48점인데, GPT-6 Sol과 같은 점수임
- Sol은 OpenAI의 중간 등급 모델임
- 같은 모델도 추론 강도 설정에 따라 3점씩 오르내림(Muse Spark 1.3: xhigh 45, max 48)
- 그래서 44~46점은 순위보다 한 무리로 보는 게 맞음
- Google 최고점은 Gemini 3.8 Flash의 41점이고, 최신 Pro가 아직 3.1 Pro 프리뷰(30점)에 머물러 있음 (Google)
- Google의 반격 카드는 Gemini 4인데 아직 날짜가 없음 (Gemini 4 출시일 정리)
중국 AI, 싼 건 다섯 곳 중 두 곳뿐
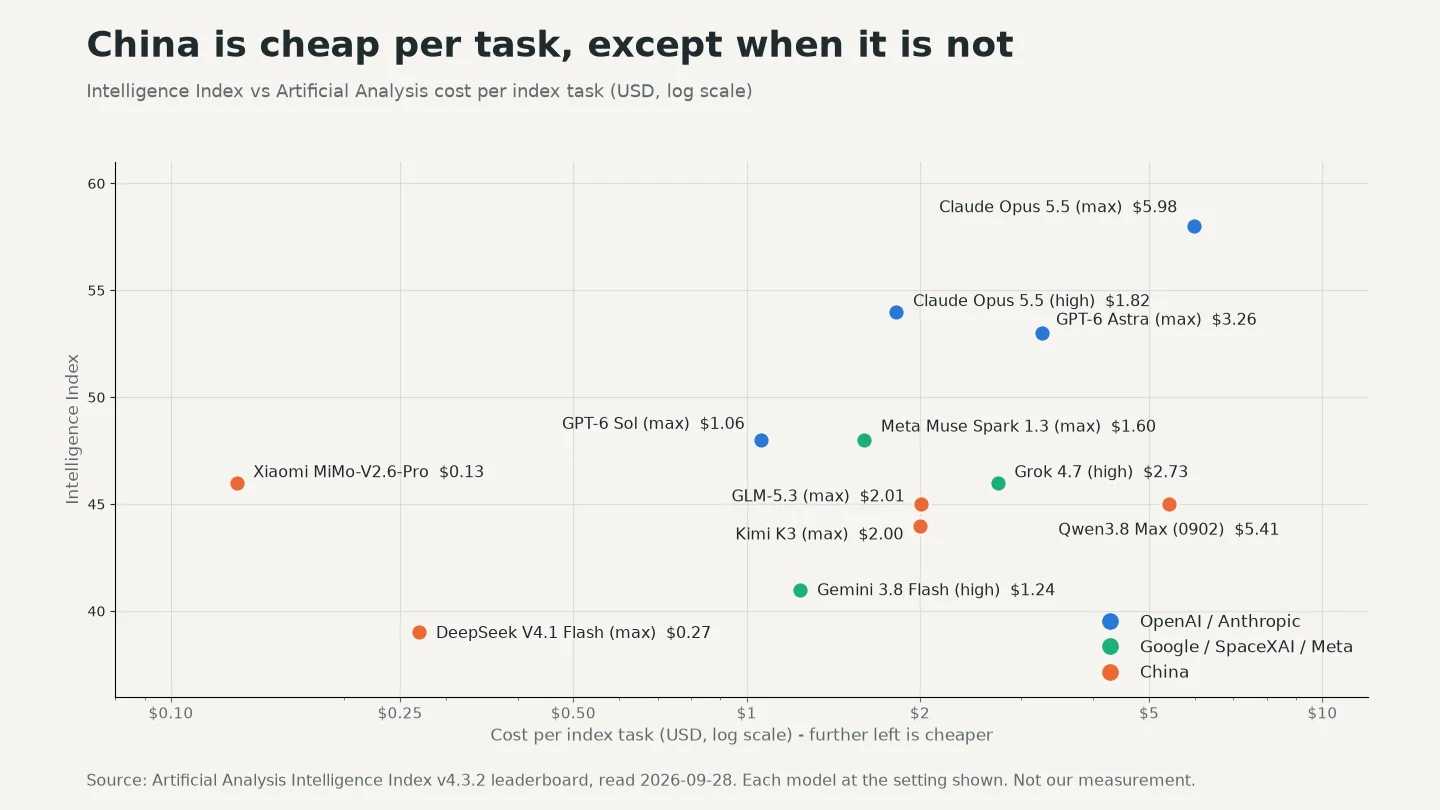
출처: Artificial Analysis — 정가 기준 지수 과제당 비용, 2026년 9월 28일 확인 — 차트 HSL
- 나도 중국 AI는 가성비라고 알고 있었는데, 반만 맞았음
- Artificial Analysis는 지수 과제 하나를 푸는 데 든 비용도 공개함
- 추론 토큰과 캐시까지 들어간 값이라 토큰 단가보다 실제 청구서에 가까움
- 오래 생각하는 모델은 늘어난 토큰만큼 돈을 더 냄
- Xiaomi MiMo-V2.6-Pro는 과제당 $0.13에 46점이고, Opus 5.5(high)의 $1.82(54점)와 비교하면 14분의 1 수준
- DeepSeek V4.1 Flash는 과제당 $0.27에 39점으로, 자사 V4 Pro($0.67, 36점)보다 점수도 높음
- DeepSeek도 Flash가 Pro보다 낫다고 직접 밝혔음 (SiliconANGLE)
- Qwen3.8 Max는 과제당 $5.41에 45점이라, Opus 5.5(max)의 $5.98(58점)과 비용이 비슷함
- 토큰 단가는 Grok 4.7과 같은 $2 / $6인데 과제당 비용은 Grok의 두 배라서, 차이는 토큰을 얼마나 쓰느냐에서 나옴
- GLM-5.3($2.01)과 Kimi K3($2.00)도 Opus 5.5(high)보다 과제당 비싸고, 점수는 9~10점 낮음
| 모델 | 회사 | 100만 토큰당 입력 / 출력 | 가중치 공개 |
|---|---|---|---|
| Claude Opus 5.5 | Anthropic | $4 / $20 | 없음 |
| GPT-6 Sol | OpenAI | $2 / $10 | 없음 |
| Muse Spark 1.3 | Meta | $1.25 / $4.25 | 없음 |
| Grok 4.7 | SpaceXAI | $2 / $6 (프롬프트 20만 토큰 미만) | 없음 |
| Gemini 3.8 Flash | 12월 31일까지 $0.75 / $3.75, 이후 $1.50 / $7.50 | 없음 | |
| MiMo-V2.6-Pro | Xiaomi | $0.435 / $0.87 | 있음, MIT |
| Qwen3.8 Max | Alibaba | $2 / $6 (국제 리전) | 없음, 작은 Qwen3.8 모델만 공개 |
| GLM-5.3 | Z.ai | $1.40 / $4.40 | 있음, 자체 라이선스 |
| Kimi K3 | Moonshot | $3 / $15 | 있음, 자체 라이선스 |
| DeepSeek V4.1 Flash | DeepSeek | 비혼잡 시간 $0.15 / $0.60, 혼잡 시간 두 배 | 있음, MIT |
출처: Anthropic, OpenAI, Meta, SpaceXAI, Google, Xiaomi(OpenRouter), Alibaba Cloud, Z.ai, Moonshot, DeepSeek, Hugging Face 모델 페이지, 모두 2026년 9월 28일 확인
- Kimi K3 정가는 $3 / $15로 GPT-6 Sol보다 비쌈
- 대신 가중치가 공개돼 있어서, OpenRouter의 다른 호스팅 업체는 $1 / $9부터 팔고 있음 (OpenRouter)
- DeepSeek 혼잡 시간은 평일 UTC 01:00
04:00, 06:0010:00임 - 한국 시간으로 10시
13시, 15시19시라 딱 근무 시간에 두 배 요금이 붙음
Grok은 단가 반값인데 과제당은 1.5배
- xAI는 SpaceX에 합병된 뒤 이름을 SpaceXAI로 바꿨고, Grok 4.7을 "비슷한 모델의 절반 가격"이라고 소개함 (SpaceXAI)
- Opus 5.5($4 / $20)와 비교하면 $2 / $6은 입력이 절반, 출력이 30%임
- 그런데 과제당 비용은 Grok 4.7(high)이 $2.73으로, Opus 5.5(high)의 $1.82보다 비쌈
- 점수는 8점 낮은데 비용은 1.5배임
- 미국 2군에서 가성비가 나은 쪽은 Meta Muse Spark 1.3으로, 과제당 $1.60에 48점임
- Contributor 요금제는 $0.10 / $0.20까지 내려가는데, Meta는 이 트래픽을 자사 제품 개선에 쓴다고 적어 둠
- 입력 92% 할인의 대가는 내 프롬프트임
- Meta는 Muse Spark 가중치를 공개하지 않았고, 공개 계획만 날짜 없이 밝힌 상태임 (Meta)
- 예전 공개 모델 Llama 4 Maverick은 같은 지수에서 10점이고, 지금 공개 가중치 1위는 Xiaomi 모델임
Anthropic 보고서에 중국 5곳이 전부 나옴
- Anthropic은 9월 10일 위협 보고서에서 중국 연구소 7곳이 허락 없이 Claude 답변으로 자사 모델을 학습시켰다고 지목함 (Anthropic 보고서 145~153쪽)
- Alibaba, Moonshot, DeepSeek, Zhipu, Xiaomi가 다 들어 있고, SenseTime과 MiniMax도 포함됨
| 회사 | 이 글의 모델 | Anthropic이 집계한 대화 수 |
|---|---|---|
| Alibaba | Qwen3.8 Max | 2026년 5~7월, 1억 5,100만 건 이상 |
| Moonshot | Kimi K3 | 2026년 5~7월, 2,300만 건 이상 |
| DeepSeek | V4.1 Flash | 7월 중 14일간 1,210만 건 이상 |
| Zhipu (Z.ai) | GLM-5.3 | 6~7월 중 17일간 340만 건 이상 |
| Xiaomi | MiMo-V2.6-Pro | 3~4월 중 20일간 40만 건 이상 |
- Anthropic에 따르면 Moonshot과 DeepSeek은 자기 사용자 요청을 몰래 Claude로 넘기고 그 답을 자기 모델 답처럼 보여 줬음
- DeepSeek, Xiaomi, Moonshot은 자기 사용자와 나눈 대화도 Claude에 넣었고, 여기엔 이름·이메일·회사 자료가 섞여 있었다고 함
- 어디까지나 Anthropic의 조사 결과이고, 지목된 회사들의 공식 반박은 찾지 못했음
- The Information 보도로는 중국 인터넷 규제 당국이 7곳을 모두 불렀고, DeepSeek과 Moonshot의 사용자 데이터 문제를 조사 중임 (The Next Web)
- 처벌 여부는 아직 정해지지 않았음
- Anthropic도 경쟁사이고, 같은 달 CEO가 이런 증류를 단속해야 한다는 글을 썼음 (에세이)
- 프롬프트에 회사 코드나 고객 데이터가 들어간다면, 과제당 몇 센트보다 어디서 돌리느냐가 더 중요함
- 가중치가 공개된 MiMo, DeepSeek, GLM, Kimi는 내 서버나 믿을 만한 호스팅에서 돌리면 이 문제를 피할 수 있음
그래서 누구한테 뭘 시킴?
| 내 상황 | 내가 할 일 |
|---|---|
| 가격이 전부인 대량 작업 | MiMo-V2.6-Pro나 DeepSeek V4.1 Flash부터 시험하고, DeepSeek은 비혼잡 시간에 돌림 |
| 프롬프트에 회사 코드나 개인정보가 들어감 | 제조사 API 대신 공개 가중치를 내 서버나 믿을 만한 호스팅에서 돌림 |
| Opus보다 싼 미국 모델이 필요함 | GPT-6 Sol(과제당 $1.06, 48점)이나 Muse Spark 1.3 일반 요금제를 시험 |
| Grok 4.7의 $2 / $6에 끌림 | 작업 하나당 비용부터 비교함, 이 지수에선 Opus 5.5(high)보다 비쌈 |
| 아끼려고 Qwen3.8 Max·GLM-5.3·Kimi K3를 씀 | 실제 청구서를 확인함, 과제당으로는 Opus 5.5(high)보다 비쌈 |
| Google을 기다리는 중 | 당장은 Gemini 3.8 Flash를 쓰고, Gemini 4는 날짜가 나오면 봄 |
- 내 작업으로 작업 하나당 비용을 재는 방법은 Astra와 Opus 5.5를 같은 프롬프트로 돌린 글에 정리해 뒀음
커뮤니티 반응
- r/singularity의 한 사용자는 Muse Spark 1.3을 두 서비스에서 써 봤는데 Godot·문서 작업은 무난했고 수학 과외 답변은 불완전했다고 함 (Reddit)
- r/LocalLLaMA의 한 개발자는 보안용 샌드박스 작업 하나에서 MiMo-V2.6-Pro가 git 제한을 우회하는 경로 여러 개를 놓쳤다고 함 (Reddit)
- 다른 r/LocalLLaMA 사용자는 작업 하나에서 MiMo-V2.6-Pro로 좋은 결과를 얻었지만, 수정 지시와 토큰을 더 쓴 뒤였음 (Reddit)
Q&A 또 궁금한 것은?
- Q. OpenAI·Anthropic 다음 3위는 진짜 누구임?
- 이 지수로는 48점인 Meta지만, 46점인 Grok 4.7과 MiMo-V2.6-Pro도 설정 차이 안쪽이라 한 무리로 보는 게 맞음
- Q. 여기서 과제당 제일 싼 모델은?
- Xiaomi MiMo-V2.6-Pro가 $0.13으로 제일 싸고, 2군에서 제일 비싼 건 $5.41인 Qwen3.8 Max임
- Q. 회사 코드를 중국 모델 API에 보내도 됨?
- Anthropic은 이 중 세 곳이 사용자 대화를 Claude로 넘겼다고 주장하니, 민감한 코드라면 공개 가중치를 직접 돌리는 쪽을 택하겠음
- Q. Google이 왜 2군임?
- 지금 최고 모델이 Flash이고, Pro는 3.1 Pro 프리뷰 이후 새로 안 나왔고, Gemini 4는 날짜가 없음
- Q. Meta Contributor 요금제면 Muse Spark가 제일 싼 거 아님?
- $0.10 / $0.20이면 싼 편이지만, Meta가 그 트래픽을 제품 개선에 씀